Révolution des LLM Locaux : L’Étonnant Potentiel des Cartes Graphiques Intégrées AMD
Dans l’univers en pleine effervescence des grands modèles linguistiques (LLM) exécutés en local, l’idée reçue est souvent la même : pour manipuler ces géants de l’IA, une carte graphique dédiée (dGPU) puissante est non seulement recommandée, mais quasiment indispensable. Ces unités de traitement graphique discrètes sont conçues pour les calculs parallèles intensifs, ce qui les rend parfaites pour les réseaux neuronaux complexes qui animent les LLM. Bien qu’il soit techniquement possible de faire tourner un LLM sur le seul processeur (CPU), l’expérience est généralement lente, ressemblant plus à un laborieux cheminement qu’à une véritable exécution fluide, surtout en comparaison avec les performances offertes par une dGPU adéquate.
C’est précisément ce constat qui nous amène à explorer un segment fascinant et souvent sous-estimé du marché matériel : les unités de traitement graphique intégrées (iGPU) logées au sein des Unités de Traitement Accélérées (APU). Loin d’être les mastodontes que sont les dGPU de bureau haut de gamme, ces iGPU n’en demeurent pas moins des processeurs graphiques à part entière, partageant la mémoire système avec le CPU. La question intrigante se pose alors : ces solutions intégrées peuvent-elles réellement être viables pour l’exécution de LLM en local ? Pour apporter une réponse concrète, une série de tests rigoureux a été menée sur trois générations distinctes d’iGPU AMD, dans le but de pousser leurs limites et de révéler leur véritable potentiel dans le domaine de l’intelligence artificielle locale.
L’Ascension Fulgurante des Cartes Graphiques Intégrées et leur Pertinence Croissante pour l’IA
L’évolution des cartes graphiques intégrées a été tout simplement spectaculaire au cours des dernières années. Loin des simples accélérateurs d’affichage d’antan, les iGPU modernes, en particulier ceux conçus par AMD avec leurs architectures RDNA innovantes, sont devenus des composants de calcul puissants, capables de gérer des jeux vidéo légers à modérés avec brio et d’exécuter des tâches graphiques complexes. Leur avantage intrinsèque réside dans leur intégration directe au processeur (formant ainsi une APU) et leur accès à une architecture de mémoire système unifiée. Pour les charges de travail d’IA, cette architecture de mémoire unifiée est potentiellement révolutionnaire. Elle élimine les goulets d’étranglement traditionnels liés au transfert incessant de données entre la RAM système et la VRAM dédiée, un problème récurrent avec les dGPU classiques. Cette synergie permet aux LLM de charger des modèles plus grands en mémoire et de profiter d’une latence réduite, même si la puissance de calcul brute n’atteint pas le niveau des cartes dédiées ultra-haut de gamme.
Cette capacité à exploiter efficacement la mémoire unifiée et les cœurs de calcul du GPU, même intégré, ouvre de nouvelles perspectives pour démocratiser l’accès à l’IA locale, en particulier pour les utilisateurs ne disposant pas d’un budget illimité pour une dGPU de pointe. La promesse est celle d’une IA plus accessible, plus économe en énergie et plus intégrée.
Un Aperçu Détaillé des Configurations de Test : Trois Générations d’iGPU à l’Épreuve
Pour cette expérimentation unique, trois appareils emblématiques, chacun représentant une étape significative dans la progression et la puissance des iGPU AMD, ont été méticuleusement sélectionnés et préparés pour les tests :
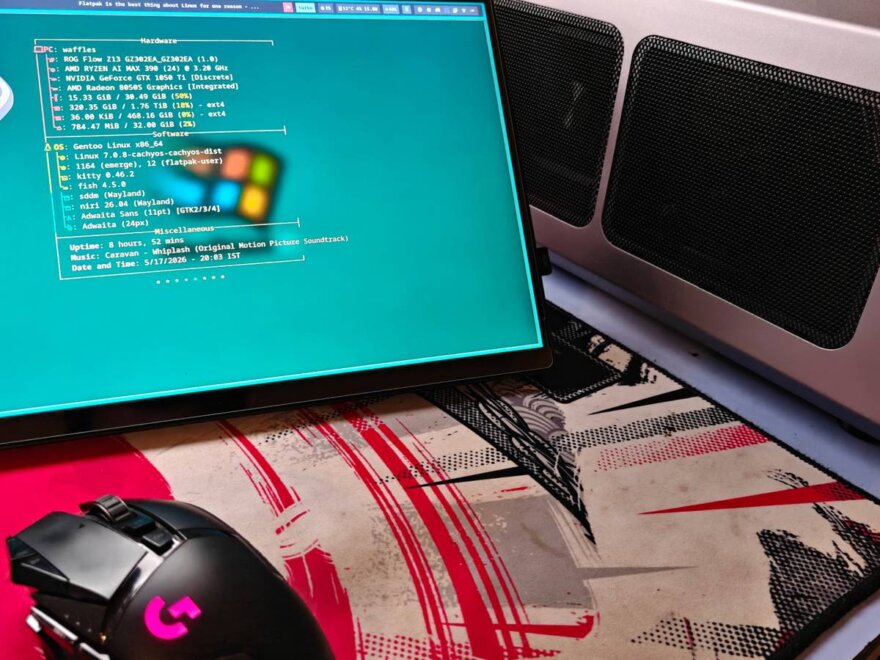
1. L’ASUS ROG Flow Z13 (AMD Ryzen AI Max 390 avec iGPU 8050S, 32 Go de RAM)
Ce formidable laptop gaming de 13,4 pouces incarne le summum des performances mobiles actuelles en matière de graphiques intégrés. Le chipset AMD Ryzen AI Max 390 est une véritable bête de course, intégrant un CPU à 12 cœurs et 24 threads, couplé à l’un des iGPU les plus véloces disponibles sur le marché grand public, le puissant 8050S. Avec ses 40 unités de calcul (CU), cet iGPU prétend offrir des niveaux de performance comparables à ceux d’une RTX 4060 mobile dans certains scénarios, une affirmation audacieuse pour une solution intégrée. La machine utilisée pour nos tests était équipée de 32 Go de mémoire système, partagée de manière transparente entre le CPU et l’iGPU. Il est important de noter que certains modèles de cette lignée peuvent être configurés avec jusqu’à 128 Go de mémoire unifiée, une capacité qui ouvre la porte à l’exécution de modèles LLM encore plus massifs et complexes. Ce système représente l’un des meilleurs kits matériels disponibles actuellement pour l’IA locale, et il était impératif de vérifier s’il était à la hauteur de son battage médiatique. Son architecture de mémoire unifiée à haute bande passante et ses capacités de calcul avancées en font un candidat de choix pour les tâches d’inférence LLM les plus exigeantes, symbolisant l’avenir de l’IA embarquée.
2. Le Lenovo Legion Go (AMD Ryzen Z1 Extreme avec iGPU 780M, 16 Go de RAM)
Le Legion Go est l’un des nombreux PC portables de jeu basés sur l’AMD Ryzen Z1 Extreme qui ont émergé comme des concurrents sérieux du Steam Deck. C’est un appareil très compétent, doté de l’iGPU Radeon 780M, une solution graphique intégrée largement saluée pour ses solides performances en jeu à des résolutions de 1080p et au-delà. Cependant, en termes de puissance de calcul brute et d’unités d’exécution, il ne rivalise pas directement avec l’iGPU 8050S du Flow Z13. La configuration de test était limitée à 16 Go de mémoire système partagée, ce qui impose naturellement certaines restrictions sur la taille des modèles LLM qui peuvent être chargés efficacement. Malgré cette limitation, le Z1 Extreme et son iGPU 780M sont représentatifs d’une génération d’APU extrêmement populaire et largement disponible, offrant un excellent équilibre entre performance, portabilité et efficacité énergétique pour les appareils compacts. Ce fut une opportunité précieuse d’évaluer une solution de milieu de gamme très courante pour l’exécution de tâches d’IA locale, reflétant une option réaliste pour un large éventail d’utilisateurs.
3. Le Ryzen 5 5600G (iGPU Vega 7, 16 Go de VRAM alloués manuellement via BIOS)
Enfin, nous avons intégré le modeste Ryzen 5 5600G, équipé de son iGPU Vega 7. Lancé il y a quelques années, le 5600G était autrefois une option fantastique pour les configurations PC économiques, offrant des performances suffisantes pour le jeu léger sans nécessiter de carte graphique dédiée. Bien que ses jours de gloire en tant que champion du gaming soient révolus, il conserve un intérêt particulier et presque historique pour ce test. L’inclusion du Vega 7 peut sembler un peu un « choix mème » ou anachronique au premier abord. Cependant, c’est précisément ce qui rend l’expérience si fascinante : peut-on réellement faire fonctionner des LLM modernes sur une architecture GPU aussi ancienne et intrinsèquement moins puissante ? Cette question est d’autant plus pertinente pour les nombreux utilisateurs qui disposent de matériel plus ancien et qui souhaitent explorer l’IA locale sans avoir à investir massivement. La mémoire système était de 16 Go, et, dans un effort pour éliminer tout goulot d’étranglement potentiel lié à la VRAM, 16 Go de VRAM ont été alloués manuellement à l’iGPU via le BIOS (la capacité maximale possible sur cette plateforme), même si la bande passante et la puissance de calcul restaient des facteurs limitants inhérents à l’architecture.
Préparation des Tests et Défis Techniques Rencontrés
La mise en place des tests était, dans son principe, relativement simple : exécuter un benchmark LLM en se basant sur quelques paramètres clés, en s’appuyant sur des scripts construits avec l’aide de Claude. L’objectif était de maximiser l’utilisation de toutes les ressources disponibles sur chaque machine. Cela impliquait d’optimiser l’utilisation de la mémoire vidéo (VRAM), bien que, comme nous le verrons dans les résultats, une VRAM abondante ne peut malheureusement pas compenser une architecture graphique intrinsèquement lente et moins efficace.
Le Ryzen 5 5600G a posé quelques défis techniques notables. L’iGPU Vega 7 (basé sur l’architecture gfx90c) ne bénéficie pas d’un support officiel pour ROCm, la plateforme logicielle d’AMD dédiée au calcul GPU haute performance. Il a donc été impératif de configurer le backend Vulkan pour assurer une meilleure compatibilité et des résultats stables et fiables. De plus, comme mentionné précédemment, l’allocation de la mémoire vidéo de l’iGPU a dû être effectuée manuellement à 16 Go via le BIOS, la capacité maximale permise. Cette manipulation visait à s’assurer qu’aucun manque de VRAM ne briderait les performances de l’iGPU, même si les résultats finaux ont montré que les limitations résidaient bien au-delà de la simple capacité mémoire pour cette architecture plus ancienne. Il a également été observé qu’Ollama, une plateforme populaire et conviviale pour exécuter des LLM localement, ne reconnaissait pas toujours les iGPU par défaut, nécessitant des ajustements spécifiques dans les fichiers de configuration pour forcer son utilisation et s’assurer que les calculs étaient bien déchargés sur l’iGPU plutôt que sur le CPU.
Analyse Détaillée des Résultats : Ce que les Chiffres Révèlent de l’Expérimentation
Les résultats des tests se sont déroulés globalement comme prévu, confirmant certaines hypothèses mais apportant également des observations particulièrement intéressantes et parfois surprenantes. Le tableau ci-dessous synthétise les performances clés mesurées pour chaque configuration :
| Métrique | Ryzen 5 5600G (iGPU Vega 7) | Z1 Extreme (CPU) | Z1 Extreme (iGPU 780M) | AI Max 390 (iGPU 8050S) |
|---|---|---|---|---|
| Vitesse de génération (tokens/s) | 17.5 | 22.4 | 44.1 | 85.1 |
| Traitement du prompt (tokens/s) | 201 | 150 | 783 | 1,609 |
| Temps par exécution (secondes) | 16.8 | 13.7 | 6.3 | 3.2 |
| Consommation moyenne (W) | 41 | 18 | 33 | 64 |
| Efficacité (tokens/s/W) | 0.43 | 1.25 | 1.34 | 1.33 |
| Température maximale (°C) | 57 | 64 | 81 | 95 |
Sans la moindre surprise, l’AI Max 390 a dominé les classements avec une marge impressionnante. Atteignant 85.1 tokens/s en génération, il est de loin le plus rapide de notre panel, confirmant avec éclat les promesses de performance de l’iGPU 8050S. Le fait qu’il puisse rivaliser avec une RTX 4060 mobile et bénéficier d’une grande quantité de mémoire unifiée et rapide (bien que malheureusement souvent soudée) lui confère un avantage décisif pour les charges de travail LLM gourmandes. Son efficacité énergétique, mesurée à 1.33 tokens/s/W, est également excellente, justifiant sa consommation électrique moyenne plus élevée (64W) par une puissance de calcul inégalée parmi les iGPU.
Le Ryzen Z1 Extreme, avec son iGPU 780M, se positionne honorablement juste derrière. Atteignant 44.1 tokens/s en génération, il est environ deux fois plus lent que l’AI Max 390, mais offre des performances remarquablement solides pour un appareil de sa catégorie et de sa taille. Son efficacité est légèrement supérieure à celle de l’AI Max (1.34 tokens/s/W), démontrant l’optimisation poussée des architectures RDNA modernes même à des niveaux de puissance inférieurs. C’est une excellente option pour ceux qui recherchent un équilibre optimal entre portabilité, puissance et coût pour l’IA locale. Il est également crucial de noter que l’iGPU 780M surpasse nettement le CPU Z1 Extreme seul en matière de vitesse de génération et de traitement de prompt, soulignant l’avantage indéniable du calcul parallèle GPU pour les tâches LLM.
Enfin, le Vega 7 du Ryzen 5 5600G a terminé, comme attendu, bon dernier. Avec seulement 17.5 tokens/s en génération, il est près de cinq fois plus lent que l’AI Max 390. Mais le point le plus frappant est sans doute son efficacité : avec 0.43 tokens/s/W, il est de loin le moins efficient de tous, consommant 41W pour une performance relativement modeste. Cela met en lumière les progrès considérables réalisés par AMD entre les générations d’iGPU en termes d’architecture et d’efficacité. Malgré tout, l’observation la plus remarquable n’est pas sa lenteur, mais le simple fait qu’il ait pu exécuter le LLM. Pour une architecture datant de plusieurs années et non spécifiquement optimisée pour les charges de travail d’IA modernes, c’est une prouesse technique en soi, même si l’expérience utilisateur serait loin d’être fluide ou réactive. La capacité de charger et d’inférer un modèle moderne, même lentement, sur un tel matériel ouvre des perspectives intéressantes pour l’expérimentation et l’apprentissage sur des machines plus anciennes ou à budget limité.
L’Avenir Prometteur de l’IA Locale avec la Mémoire Unifiée et les iGPU
Les résultats de ce test confirment une tendance claire et irréfutable : les cartes graphiques intégrées, en particulier celles bénéficiant d’un accès à une mémoire unifiée rapide et abondante, sont en train de se positionner comme le futur de l’IA locale. L’AI Max 390 démontre de manière éclatante qu’un iGPU moderne et puissant peut non seulement tenir tête mais aussi rivaliser efficacement avec des dGPU dédiés de milieu de gamme, offrant des performances impressionnantes pour l’inférence LLM. Cette convergence du CPU, du GPU et de la mémoire sur une seule puce (APU) est une architecture d’ingénierie brillante qui réduit la latence, augmente la bande passante disponible pour les modèles d’IA et optimise la consommation d’énergie, des facteurs cruciaux pour des performances optimales et une IA plus réactive.
Cependant, il convient d’aborder un « éléphant dans la pièce » : le prix. Les machines équipées d’APU Ryzen AI Max représentent un investissement conséquent et ne sont malheureusement pas accessibles à toutes les bourses. Cette technologie de pointe a un coût, et cela limite son adoption massive pour l’instant. Néanmoins, la performance brute qu’elles offrent, combinée au support croissant de la communauté et à l’optimisation continue des frameworks d’IA, les rend extrêmement attrayantes pour les développeurs, les chercheurs et les enthousiastes qui cherchent à repousser les limites de l’IA locale. La mémoire unifiée, bien que d’une efficacité redoutable, est malheureusement souvent soudée à la carte mère, ce qui la rend non-évolutive ; c’est un compromis pour atteindre ces niveaux d’intégration et de performance de pointe.
L’expérience avec le 5600G, bien que lente et peu pratique pour une utilisation quotidienne, prouve la flexibilité et la résilience des architectures modernes d’IA. Même si l’exécution n’est pas optimale, la simple capacité d’exécuter un LLM sur du matériel « ancien » est fascinante et ouvre des portes à l’expérimentation et à l’apprentissage pour un public plus large. À mesure que les logiciels d’IA deviennent plus optimisés pour les architectures hétérogènes et que les iGPU continuent d’évoluer en termes de puissance et d’efficacité, nous pouvons nous attendre à voir des performances encore plus impressionnantes et une plus grande accessibilité. L’avenir de l’IA est de plus en plus local, et les APU avec leurs iGPU joueront un rôle de plus en plus central dans cette démocratisation progressive.
Conclusion : Les iGPU, Futurs Piliers de l’Intelligence Artificielle Locale ?
En résumé, nos tests démontrent de manière irréfutable que les cartes graphiques intégrées ont atteint un niveau de maturité qui les positionne comme des acteurs viables, voire puissants, pour l’exécution de LLM en local. Alors que les architectures plus anciennes comme le Vega 7 montrent des signes de faiblesse attendus en termes de performance brute et d’efficacité, leur capacité à simplement faire tourner un modèle est en soi une réussite technique remarquable. Les générations intermédiaires, incarnées par le Ryzen Z1 Extreme et son iGPU 780M, offrent un excellent compromis entre coût, performance et portabilité, rendant l’IA locale accessible sur des appareils du quotidien, y compris les consoles portables. Au sommet de cette hiérarchie, l’AMD Ryzen AI Max 390 avec son iGPU 8050S redéfinit audacieusement ce qui est possible avec les graphiques intégrés, délivrant des performances qui rivalisent sérieusement avec des cartes graphiques dédiées de milieu de gamme.
Cette étude approfondie met en évidence le potentiel immense des APU et de leurs iGPU dans le paysage de l’intelligence artificielle locale. Avec l’amélioration continue des architectures, l’augmentation de la bande passante et de la capacité de la mémoire unifiée, ainsi que l’optimisation incessante des frameworks logiciels et des outils d’inférence, l’IA locale sur iGPU n’est pas seulement une réalité, mais une tendance appelée à se renforcer et à se démocratiser. Bien que le prix reste un obstacle pour les solutions les plus performantes et les plus récentes, la direction est claire : l’avenir de l’IA est plus proche, plus personnel et de plus en plus intégré, rendant l’intelligence artificielle de pointe accessible directement sur nos appareils quotidiens, ouvrant la voie à des innovations futures passionnantes et à une interaction plus profonde avec la technologie.